>_
automate_this
Г
Это демо
Потыкай, посмотри как устроено — а чтобы начать, заведи аккаунт: M0 бесплатно.

M0-18Саммари блога через AI в Telegram

тренажёрfree
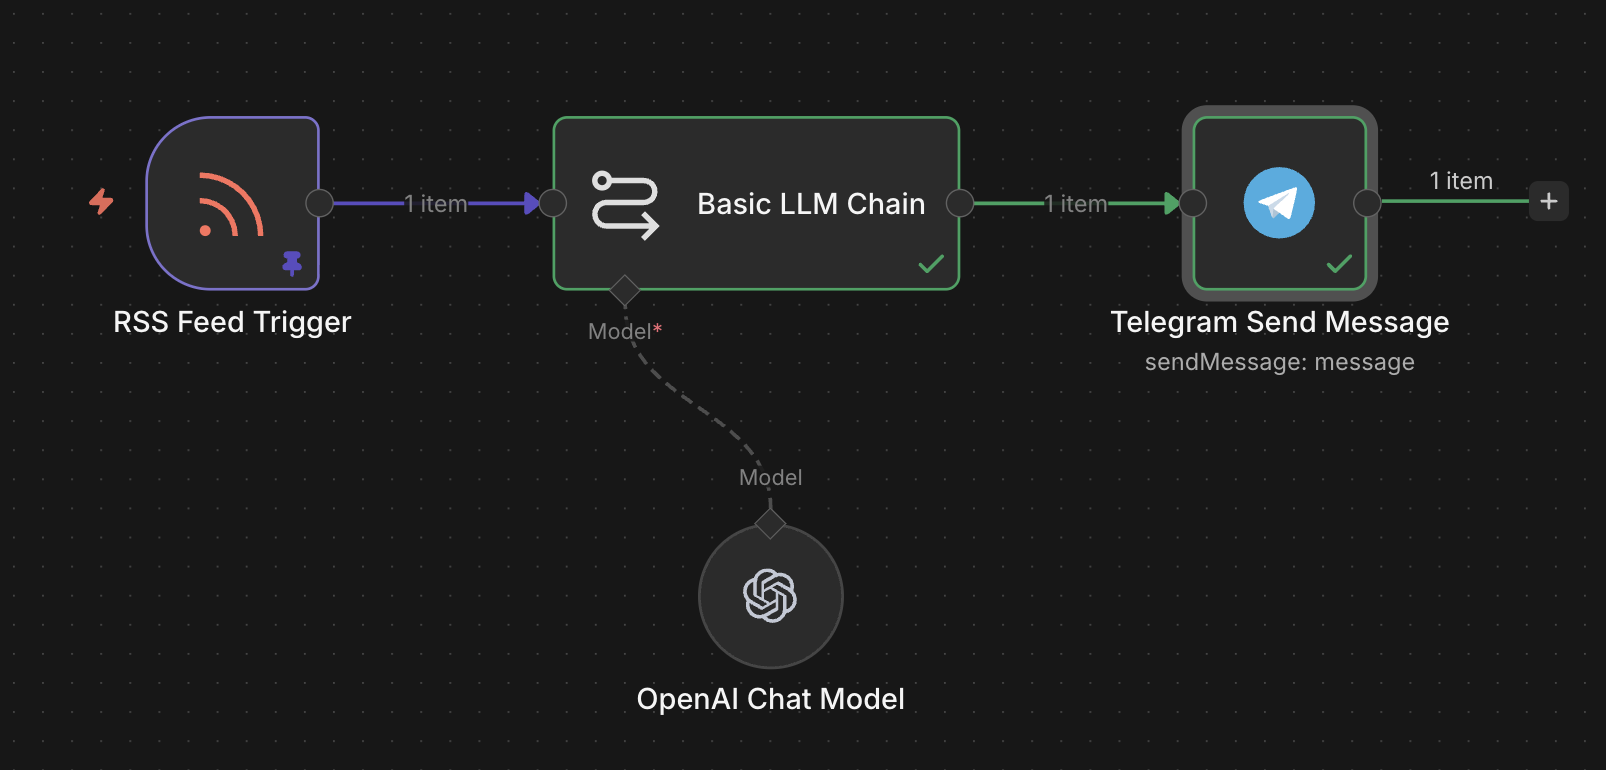
Представь: ты следишь за индустрией через несколько блогов, но читать каждую статью целиком — нет времени. Хочется получать короткое саммари в три предложения, чтобы понять о чём статья и решить, стоит ли разворачивать полный текст. Соберём воркфлоу из трёх нод: он сам опрашивает RSS-ленту блога, прогоняет каждую новую статью через языковую модель с просьбой «суммируй в трёх предложениях», и присылает саммари в Telegram.
#rss#ai#llm#telegram#monitoring

Что собираем

Три основные ноды плюс одна sub-нода.

RSS Feed Trigger периодически проверяет RSS-ленту и запускает воркфлоу, когда выходит новая статья.

Basic LLM Chain — кластерная нода. Она берёт текст статьи из RSS, добавляет к нему инструкцию «сделай саммари в 3 предложениях» и отправляет всё это в языковую модель. Модель возвращает короткое саммари.

К Basic LLM Chain снизу подключается sub-нода OpenAI Chat Model — это «мозг» цепочки. Она обращается к языковой модели deepseek-chat через школьный прокси.

Telegram Send Message отправляет полученное саммари в чат с тобой в Telegram.

Главное новое в этой задаче — параметр Source for Prompt в Basic LLM Chain. До этого Basic LLM Chain работал в паре с Chat Trigger и брал текст пользователя из чата автоматически. Здесь триггер не чат, а RSS — поэтому нужно переключить Source for Prompt на Define below и самому составить prompt из текста статьи и инструкции.

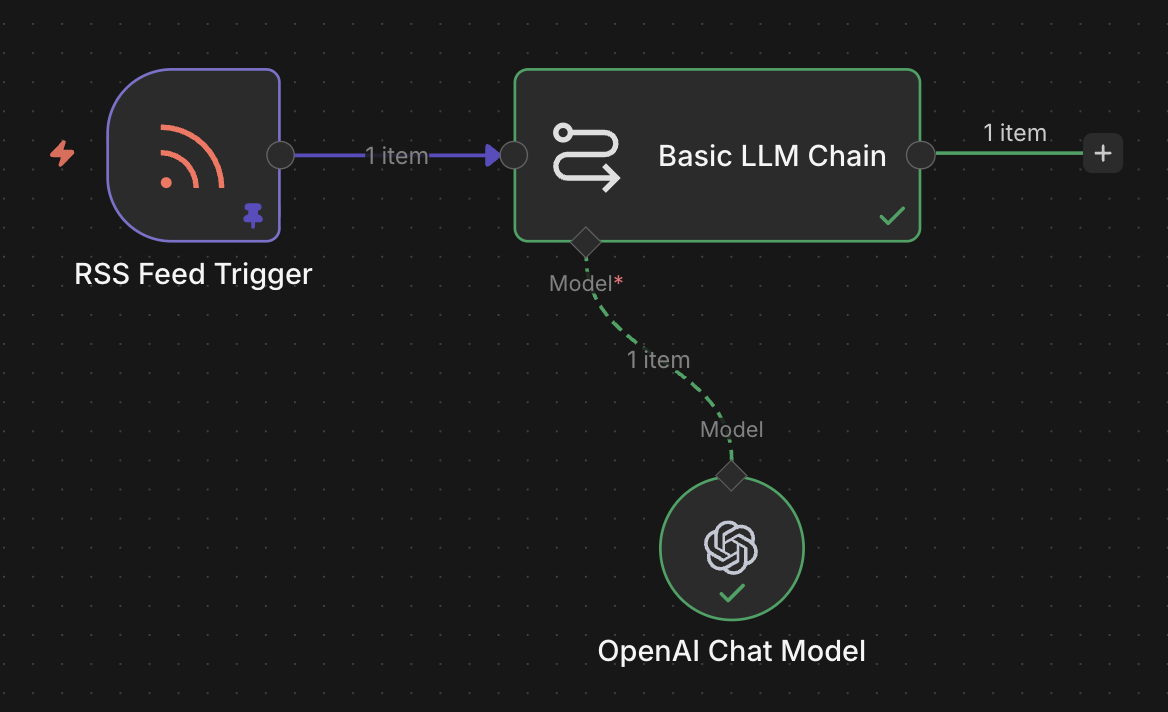
Готовый воркфлоу: RSS Feed Trigger → Basic LLM Chain → Telegram Send Message, снизу sub-нода OpenAI Chat Model
Итоговый воркфлоу

Шаги выполнения

1Получи токен у @BotFather

Создаём бота через @BotFather и получаем токен — токен нужен n8n, чтобы сообщения шли от имени именно твоего бота. Подробнее про @BotFather и токен — в шпаргалке ниже.

Этот шаг ты делаешь в Telegram-приложении, n8n пока даже не открывай.

📖@BotFather: как создать собственного бота в Telegramстатья · ~2 мин

@BotFather: как создать собственного бота в Telegram

@BotFather — это официальный бот Telegram, через которого создаются все остальные боты. Других способов завести бот нет: ни сайта, ни приложения, ни консоли — только переписка с этим аккаунтом.

Зачем это нужно

Чтобы любой workflow (в n8n, Make, на собственном бэкенде) мог слушать сообщения и отвечать от имени бота, ему нужен токен Bot API. Токен выдаётся при создании бота через @BotFather. Без токена ни одна интеграция с Telegram не заведётся: токен — это пара «логин-пароль» бота при общении с Telegram Bot API.

Как это работает

Открываешь Telegram, в поиске находишь аккаунт с username BotFather (галка подлинности рядом с именем — синяя), и пишешь ему как обычному собеседнику. Команды начинаются со слэша:

  • /newbot — создать нового бота. @BotFather спросит две вещи:
  • отображаемое имя (любое, может быть с пробелами и кириллицей) — то, что увидят пользователи в шапке чата;
  • username (только латиница, цифры, подчёркивание; обязательно заканчивается на _bot или bot) — постоянный идентификатор, по которому бот ищется и не меняется.
  • /mybots — список всех твоих ботов, доступ к настройкам (имя, описание, аватарка, команды, токен).
  • /revoke — отозвать старый токен и получить новый (если старый утёк).

После /newbot приходит сообщение с токеном — длинная строка вида 123456789:ABCdefGHI_jklMNO.... Это и есть тот самый Bot API token: его копируешь и сохраняешь в безопасное место (менеджер паролей, заметки с шифрованием) — но не в публичный репозиторий и не в чат.

Типичные ошибки

  • Потерять токен — @BotFather показывает токен один раз; чтобы получить его снова, нужно открыть /mybots → <твой бот> → API Token. Если не нашёл — можно сгенерировать новый через /revoke, но тогда старый перестанет работать во всех уже настроенных интеграциях.
  • Скинуть токен скриншотом / в открытый чат — токен даёт полный контроль над ботом. Любой, кто его увидит, может слать сообщения от имени бота и читать всё, что ему приходит. Если утёк — сразу /revoke.
  • Username без _bot на конце — @BotFather отклонит регистрацию; правило жёсткое, придётся подбирать ещё.
  • Перепутали username и отображаемое имя — отображаемое имя меняется в любой момент через /setname, а username меняется только пересозданием бота. Если задумывался серьёзный бот — username стоит выбрать осознанно.

Когда не подходит

Через @BotFather нельзя создать юзербот (бот, который ходит под обычным аккаунтом) — это уже не Bot API, а MTProto, и токен оттуда не подходит. Также @BotFather не нужен, если бот уже создан кем-то другим и тебе просто передали готовый токен — тогда сразу заводишь credential в нужном сервисе и работаешь с ним.
📖Telegram: как устроен мессенджер — клиенты, серверы, чаты и ботыОткрыть
1.1
Найди @BotFather в Telegram

В Telegram найди аккаунт @BotFather (синяя галка подлинности рядом с именем). Открой с ним чат.

1.2
Отправь команду /newbot

В чате с @BotFather отправь команду /newbot. Это команда создания нового бота — после неё @BotFather задаст два вопроса по очереди.

1.3
Заполни отображаемое имя бота

На первый вопрос @BotFather («Alright, a new bot. How are we going to call it?») впиши любое отображаемое имя — то, которое будут видеть пользователи в чате. Например, AI-помощник Вася. Кириллица и пробелы разрешены.

1.4
Заполни username бота

На второй вопрос («Good. Now let's choose a username for your bot.») впиши уникальный идентификатор латиницей, обязательно заканчивающийся на _bot или bot. Например, vasya_ai_helper_bot.

Если имя занято — @BotFather попросит ещё раз. Подбирай пока не примет.

1.5
Сохрани токен в надёжное место

В ответ @BotFather пришлёт сообщение с токеном — длинная строка вида 123456789:ABCdefGHI_jklMNO.... Скопируй её и сохрани в надёжное место (менеджер паролей, личная заметка) — токен это полный доступ к боту, светить его нельзя.

🎯
Тренажёр модуля I-Telegram
Если впервые создаёшь Telegram-бота — пройди модуль про Telegram.
2Добавь и настрой RSS Feed Trigger

Это polling-триггер: нода сама периодически ходит по RSS-ссылке и проверяет, не появились ли новые записи.

В режиме разработки — нажав Fetch Test Event — нода скачает несколько последних постов, чтобы у тебя были данные для настройки следующих шагов.

Когда воркфлоу будет опубликован, нода запомнит то, что уже видела, и в дальнейшем будет выдавать только новые статьи.

📖Что такое RSS — короткое объяснениестатья · ~2 мин

RSS — лента, которую забирают по расписанию

RSS — это адрес вида https://site.ru/feed.xml, по которому сайт отдаёт список последних записей в машинно-читаемом виде. Любая программа может скачать этот файл и получить заголовки, ссылки и даты публикаций без посещения страниц.

Это pull-модель. Сайт не отправляет уведомления сам. Подписчик сам обращается к ленте через равные промежутки времени и сравнивает, что появилось нового.

Каждая запись в ленте содержит стандартный набор полей: заголовок, ссылка, дата публикации и обычно короткий текст или фрагмент. Запись считается новой, если её не было в предыдущей выдаче. Именно это сравнение и даёт триггер для автоматизации.

RSS встречается на блогах, новостных сайтах, в релизах GitHub, подкастах и на форумах. Специальные ноды RSS Read и RSS Feed Trigger сами разбирают XML и отдают готовый массив items. Парсить руками не нужно.

Как это работает

Сайт публикует файл ленты и обновляет его при появлении новых материалов. Клиент (в том числе n8n) периодически скачивает этот файл целиком. Сравнивает список записей с тем, что было в прошлый раз, и обрабатывает только новые элементы.

  • Лента обновляется не мгновенно. Между публикацией и появлением записи в XML может пройти от нескольких минут до часа.
  • Поля title, link, pubDate и content уже разобраны нодами, их можно сразу использовать в выражениях.
  • Если ленты на сайте нет, RSS не поможет. Нужно искать API или парсить страницы напрямую.
Правило одной строкой
RSS — это всегда pull, никогда push

Сайт не пришлёт обновление сам. Автоматизация сама ходит за лентой по расписанию и сама определяет, что появилось нового.

Типичные ошибки

  • Ждут push-уведомлений от сайта → лента не меняется до следующего опроса → нужно настроить расписание и закладывать задержку в сценарий.
  • Пытаются получить запись через секунды после публикации → лента обновляется с лагом → проверять наличие записи не раньше чем через 15–30 минут.
  • Используют RSS для сбора данных с любого сайта → у многих ресурсов ленты просто нет → искать официальный API или переходить к парсингу HTML.
  • Пробуют разбирать XML регулярными выражениями → ноды уже возвращают готовый массив с полями title, link и pubDate → работать с этими полями напрямую, не лезть в исходный XML.
📖RSS: формат веб-лент для подписки на обновленияОткрыть
📖Polling-триггер: как нода сама ходит за даннымистатья · ~2 мин

Polling-триггер: как нода сама ходит за данными

Polling-триггер — это нода, которая периодически сама обращается к источнику данных по расписанию. Она не ждёт уведомления извне, а каждые N секунд или минут отправляет запрос и проверяет, появились ли новые записи.

Такой механизм называют pull-моделью: инициатива всегда у n8n. Источник (RSS, база данных, старый API) ничего не знает о клиенте и не умеет сам отправлять данные.

Как это работает

Polling-триггер работает в два этапа. При первом запуске нода получает все доступные записи и сохраняет слепок состояния — «что уже видело». При последующих запусках она запрашивает данные заново и отдаёт только те записи, которых не было в слепке.

Слепок сохраняется только после того, как workflow переведён в режим Published. В режиме Test слепок не фиксируется, поэтому каждый тест возвращает одни и те же данные.

Сравнение с push-моделью (Webhook):

ПризнакPollingWebhook
Кто инициируетn8n (запросы по таймеру)источник (отправляет сам)
Требования к источникуобычный REST / RSS / файлпубличный URL и доступ извне
Задержка данныхот 15 секунд до интервала опросапочти мгновенная
Нагрузка на APIпостоянные запросызапросы только при событии

Polling применяют, когда у источника нет Webhook: RSS-ленты, старые SaaS, прямой доступ к базе или файлам на диске. Пример — RSS Feed Trigger.

Правило одной строкой
Pull всегда инициирует n8n

Polling-триггер сам ходит к источнику через равные интервалы. Источник не уведомляет n8n — он просто отвечает на запросы.

Типичные ошибки

  • Выбрал интервал 5 секунд → быстро исчерпал квоту API источника и получил rate-limit → поставь интервал, который соответствует реальной скорости появления данных.
  • Поставил интервал 1 час → новые записи приходят с задержкой до часа → уменьши интервал, если данные критичны по времени.
  • Ожидал, что RSS Feed Trigger поведёт себя как Webhook → workflow не запустился при обновлении ленты → помни, что polling сам инициирует запросы, а webhook ждёт входящий вызов.
  • Проверил триггер в режиме Test → каждый тест возвращает одни и те же записи → перейди в Published, чтобы слепок состояния начал сохраняться.
2.1
Добавь ноду RSS Feed Trigger

На пустом canvas нажми + → в поиске нод введи RSS → выбери RSS Feed Trigger.

📖Как добавить ноду в n8nстатья · ~2 мин

Добавление ноды на canvas

Чтобы продолжить цепочку, нужно вставить новую ноду после существующей или на пустой canvas. Для этого открывают панель выбора нод тремя способами: кнопка Open nodes panel в центре canvas, кнопка Add node на стрелке соединения и + на output-коннекторе любой ноды.

Панель называется What happens next?. В ней сразу видно категории и поле поиска.

Как это работает

  • Клик по Open nodes panel или Add node открывает список.
  • В поле Search nodes... вводят имя ноды или сервиса (например http, slack, schedule). Список фильтруется по мере ввода.
  • Навигация по категориям: AI, Action in an app, Data transformation, Flow, Core, Human review, Add another trigger.
  • Клик по названию ноды ставит её на canvas и сразу открывает панель Parameters.
  • На пустом canvas можно нажать клавишу Tab — откроется та же панель без клика мышью.

Первая нода любого воркфлоу должна быть триггером (Schedule Trigger, Webhook, Manual и подобные). Обычные ноды-действия в начало ставить нельзя.

Правило одной строкой
Первая нода — всегда триггер

Если первой стоит обычная нода-действие, воркфлоу не запустится. Начинай всегда с триггера.

Типичные ошибки

  • Поставил обычную ноду первой → воркфлоу не из чего стартовать → замени первую ноду на триггер из категории Core или через поиск.
  • Ищут ноду по русскому названию → список остаётся пустым → вводи английское имя сервиса в поле Search nodes....
  • Целятся мышью в мелкий + на стрелке → промахиваются → нажми Tab прямо на canvas.
  • Открывают категорию Add another trigger после уже существующей ноды → добавляют лишний триггер → для обычного шага используй поиск или категории Action in an app и Data transformation.
2.2
Заполни поле URL адресом RSS-ленты

В поле Feed URL вставь адрес RSS-ленты.

Например, для Хабра: https://habr.com/ru/rss/all/all/

Убедись, что это именно ссылка на RSS-ленту, а не адрес главной страницы сайта. RSS-ссылки часто содержат /feed/, /rss/ или заканчиваются на .xml.

Иначе нода не сможет прочитать данные.

Чтобы понять, как выглядит RSS-лента и чем она отличается от обычной страницы сайта, вставь https://habr.com/ru/rss/all/all/ в адресную строку браузера и открой её.

2.3
Настрой частоту проверки

В секции Poll Times нажми Add Poll Time.

В появившемся правиле выбери режим Every Minute — нода будет проверять ленту раз в минуту.

Такой интервал удобен при тестировании: изменения видны быстро. На практике для новостных лент обычно хватает одного раза в 5–15 минут.

2.4
Проверь параметры ноды
Параметры RSS Feed Trigger
ПараметрЗначение
Feed URLhttps://habr.com/ru/rss/all/all/
Poll Times 1 → ModeEvery Minute
2.5
Запусти Fetch Test Event

Нажми кнопку Fetch Test Event в правом верхнем углу ноды.

Нода скачает последние посты из ленты — в панели Output появятся поля title, link, content, contentSnippet, date и другие. Эти данные понадобятся для настройки следующего шага.

Описание скрина
📖Кнопка «Execute step»: запуск одной ноды без всего воркфлоустатья · ~2 мин

Запустить одну ноду, не дёргая весь workflow

Execute step — это кнопка внутри панели ноды (открывается двойным кликом по ноде). По смыслу — младший брат большой кнопки Execute workflow внизу холста: та запускает весь воркфлоу с начала, эта — только текущую ноду. Удобно, когда настраиваешь параметры и хочешь сразу видеть, что отдаёт нода, не перезапуская всю цепочку.

Как это работает

Когда ты жмёшь Execute step, n8n берёт уже существующие данные на входе ноды (output предыдущей ноды из последнего прогона) и прогоняет через эту ноду. Сама нода выполняется реально: HTTP-запрос уходит, запись в базу пишется, письмо отправляется. Это не «сухой прогон», а полноценное выполнение — только одного шага.

  • key: Execute workflow

value: Запускает весь воркфлоу от триггера. Нужен полный прогон с самого начала. Каждый раз заново дёргает все API.

  • key: Execute step

value: Запускает только эту ноду. Берёт вход из последнего output предыдущей ноды. Идеально для подбора параметров и отладки.

  • key: Когда работает

value: Только если на входе ноды есть данные с прошлого прогона. Если ни разу не запускал предыдущие — кнопка либо ничего не вернёт, либо упадёт «No input data».

Типичный сценарий: запустил весь воркфлоу один раз (Execute workflow), увидел что нода HTTP Request отдаёт не то, поправил поле URL, нажал Execute step — увидел новый результат за секунду. Предыдущие ноды повторно не выполнялись.

У триггеров кнопка называется иначе
Смысл тот же — запустить один шаг и получить тестовое событие

У некоторых триггерных нод n8n кнопка Execute step подписана по-другому, потому что у триггера нет «входа» — он сам должен сходить за событием. Например, у RSS Trigger она называется Fetch Test Event: клик подтянет последние записи из ленты и положит их на выход ноды как тестовый input для остального воркфлоу. Работает идентично Execute step обычной ноды — точно так же используется для отладки и подбора параметров без полного прогона.

Важно про побочные эффекты
Каждый Execute step — это реальный вызов

Нода с записью в базу или отправкой сообщения каждое нажатие Execute step делает реально: 5 нажатий = 5 записей / 5 писем. Для отладки таких нод используй тестовые данные или подменяй credentials.

Типичные ошибки

  • Жать Execute step на ноде, у которой ещё не было входных данных → «No input data», нода не запустится. Сначала прогони весь воркфлоу через Execute workflow или хотя бы триггер вручную, чтобы у каждой ноды появился output.
  • Использовать Execute step для проверки изменений в предыдущих нодах → текущая нода работает со старым output, изменения не подхватятся. Если поправил предыдущую ноду — перезапусти её, а потом уже текущую.
  • Тестировать ноду с побочным эффектом (запись в БД, отправка письма) на проде → каждый клик создаёт реальную запись. Использовать тестовый credential или временно подменять параметры на безопасные.
📖JSON: формат данных, синтаксис и типыОткрыть
2.6
Запинь полученные данные

Нажми Pin над панелью Output.

Это «заморозит» данные в ноде: пока настраиваешь следующие ноды, не нужно снова ждать новой статьи в RSS — n8n будет использовать уже скачанные записи.

📖Pin Data в n8n: как зафиксировать тестовый вход нодыстатья · ~2 мин

Pin Data в n8n: как зафиксировать тестовый вход ноды

Pin Data — это способ «прибить» к ноде заранее заготовленные данные, которые n8n будет подставлять вместо настоящего входа на каждом тестовом запуске. Полезно, когда дёргать реальный источник (внешний воркфлоу, веб-хук, API) на каждое нажатие Execute workflow неудобно или невозможно.

Зачем это нужно

Часто отлаживается не сам триггер, а ноды после него — логика, маппинг, запрос в базу. Чтобы не звать каждый раз источник данных (другой воркфлоу, бот, форму), удобнее один раз получить пример настоящего входа, зафиксировать его на триггере и потом крутить запуски сколько нужно.

Поэтому Pin Data — это инструмент разработчика на этапе сборки, не часть рабочего воркфлоу. В боевом режиме закреплённые данные перестают использоваться: n8n берёт реальный вход.

Как это работает

К любой ноде с выходом можно прикрепить «запинённый» JSON. После этого:

  • При запуске воркфлоу через UI (Execute workflow, тестовый прогон) n8n не вызывает саму ноду, а сразу выдаёт следующим нодам зафиксированные данные.
  • Pin Data привязана к конкретной ноде, не к workflow целиком — можно запинить триггер и оставить остальные ноды живыми.
  • На холсте у запинённой ноды появляется визуальный значок (булавка/иконка), чтобы не забыть, что данные «искусственные».

Удобнее всего пинить триггер: на нём поле выхода — то, что в боевом режиме приходит снаружи (Telegram-апдейт, тело веб-хука, поля Execute Workflow Trigger). Тестовый JSON собирают с теми же ключами, что отдаёт реальный источник.

К примеру
Где это встречается

К примеру, в Sub-Workflow с триггером Execute Workflow Trigger пин на триггере позволяет запускать сам Sub-WF кнопкой сверху и отлаживать ноды после триггера, не запуская вызывающий workflow. Иногда — пин ставят на ноде HTTP Request к платному API, чтобы при разработке не жечь квоту запросами «ещё разок проверить парсинг».

Типичные ошибки

  • Забыли про пин при отладке — в редакторе тестовые прогоны идут по закреплённым данным, а не по реальным, поэтому новый вход «не доходит». Боевому запуску пин не мешает, но перед проверкой на живых данных его лучше снять.
  • Структура запинённого JSON не совпадает с реальным — отладка проходит идеально, но в проде ломается на полях, которых не было в тестовом примере; делайте пин из реальной execution, а не «на глаз».
  • Запинили середину воркфлоу, забыли — переименовали поле в ноде до пина, а пин остался со старой структурой. Следующие ноды читают «фантомные» данные.
  • Pin Data перепутали с переменными среды — пин не передаётся между воркфлоу и не сохраняется при экспорте на другую инсталляцию n8n как «конфиг»; это именно отладочный фиксаж.

Когда не подходит

Pin Data не заменяет настоящие тесты — это удобство в редакторе, не автоматизация. Если нужна повторяемая проверка с разными входами, лучше делать отдельный тестовый workflow или мини-набор тест-кейсов; пин подходит, когда хочется быстро прогнать «один и тот же» сценарий N раз.

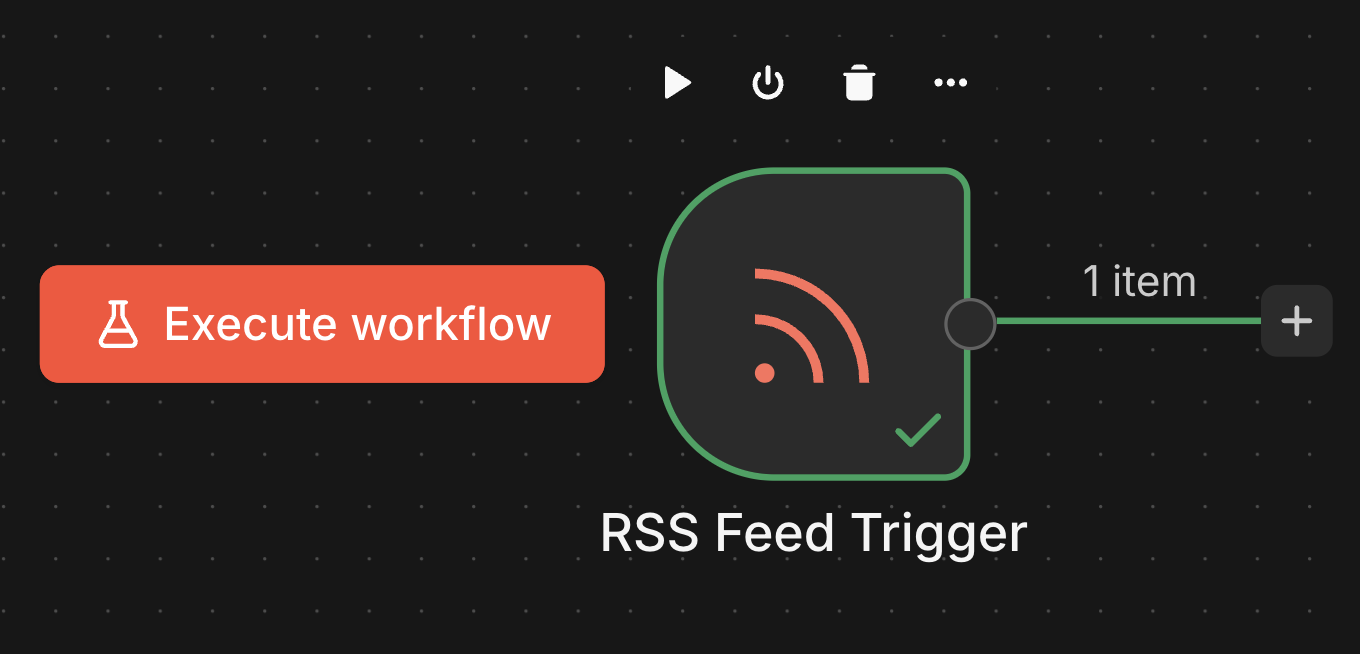
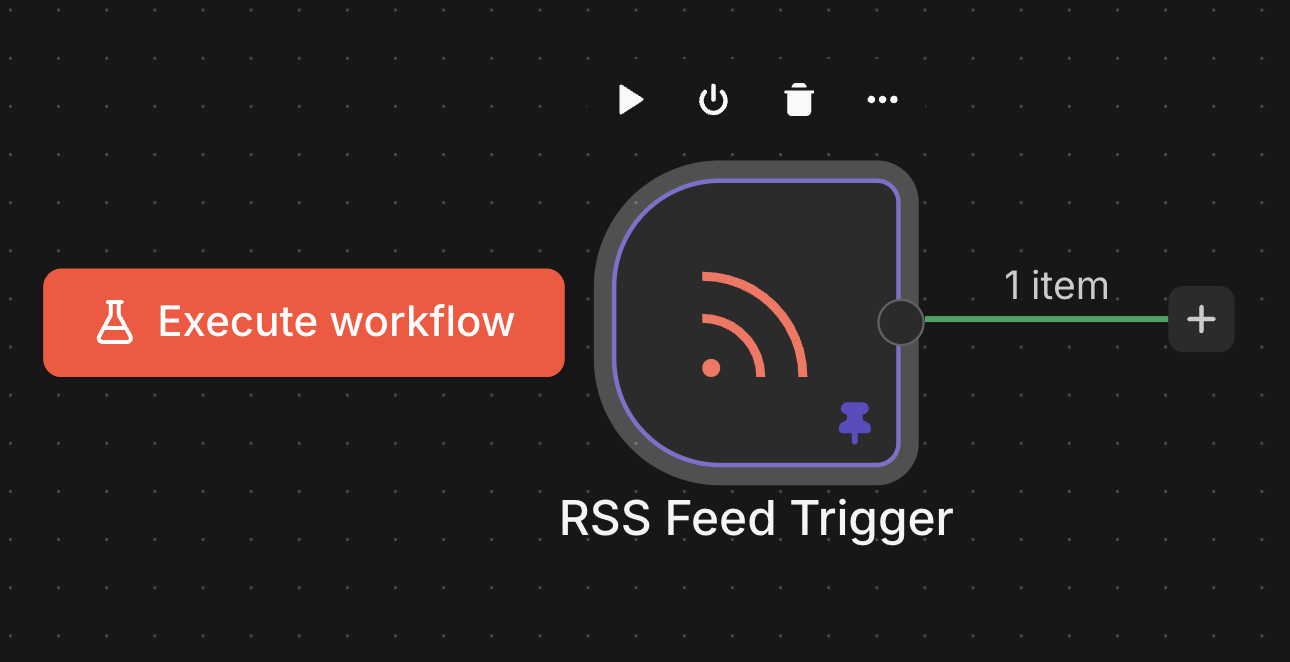
Воркфлоу после шага 2 — RSS Feed Trigger добавлен, данные запинены
Воркфлоу после шага 2 — RSS Feed Trigger добавлен и протестирован
3Подключи Basic LLM Chain и OpenAI Chat Model как sub-ноду

Третья нода — Basic LLM Chain. Это кластерная нода.

Сама по себе она не умеет отвечать — ей нужен «мозг», sub-нода OpenAI Chat Model, которая обращается к языковой модели. Без sub-ноды кластерная нода не работает.

Basic LLM Chain берёт текст из своего поля Prompt, отдаёт его в sub-ноду и возвращает ответ модели в Output.

📖Нативные AI-ноды, Basic LLM Chain и AI Agent — в чём разницастатья · ~3 мин

Три ноды — одна модель, три разных задачи

В n8n запрос к языковой модели можно отправить тремя классами нод: нативная нода вендора (OpenAI, Anthropic, Google Gemini — пункт «Message a Model»), Basic LLM Chain и AI Agent. У всех трёх под капотом — вызов LLM, но устроены они по-разному и решают разные задачи. Выбор не на вкус: для одного кейса подходит одна, для другого — другая.

Сравнение по основным свойствам
  • Нативная нода вендора — одна нода, один HTTP-запрос к API конкретного провайдера. Без sub-нод. Модель и её параметры (название, температура, max_tokens) задаются прямо в полях ноды. Память, инструменты, парсеры — не поддерживает. Используется как обычное «действие»: на вход — твой промпт, на выход — текст ответа модели.
  • Basic LLM Chain — нода-родитель из стека LangChain. Модель подключается sub-нодой снизу (Chat Model OpenAI, Chat Model Anthropic и т. д.) — поэтому одну и ту же ноду можно перевести с одного вендора на другого, не переписывая логику. Один проход: собрал prompt → отдал модели → получил ответ. Опционально подключается Output Parser sub-нода для структурированного вывода (JSON по схеме).
  • AI Agent — тоже LangChain-родитель, но с циклом внутри. Принимает sub-ноды Chat Model, Memory (история диалога), Tools (инструменты, которые модель может вызывать). Внутри работает ReAct-loop: модель сама решает, какой tool позвать, агент его выполняет, результат возвращает в модель, повторяет — пока модель не выдаст финальный ответ.

Когда что выбирать

  • Нативная нода вендора — когда нужен один простой вызов к конкретной модели и больше ничего: классификатор текста, переписать одно сообщение, извлечь сущности по промпту. Минимум абстракций, максимум контроля над параметрами вендорского API (например, response_format у OpenAI). Память истории придётся собирать руками — нода её не ведёт.
  • Basic LLM Chain — когда нужен один вызов, но с возможностью менять модели и/или вытаскивать структурированный вывод через парсер. Типичный кейс: «сгенерируй JSON по схеме». Сегодня модель OpenAI, завтра — Gemini, ноду переключать не надо, меняешь только sub-ноду Chat Model.
  • AI Agent — когда модели нужны инструменты (поиск в БД, вызов API, доступ к Sub-Workflow) или память диалога между сообщениями пользователя. Бот, который помнит разговор, ассистент с инструментами, агент с RAG — это AI Agent. Бот, который отвечает на каждый вопрос отдельно, без памяти и инструментов, обходится Basic LLM Chain.
Главная тонкость
AI Agent без tools — это не Basic LLM Chain

Если поставил AI Agent без подключённых инструментов, по сути получишь дорогой Basic LLM Chain с лишним loop'ом. Память и tools — единственная причина использовать Agent вместо Chain. Без них Chain быстрее, дешевле и предсказуемее.

Типичные ошибки

  • Поставил AI Agent, потому что «звучит модно», без инструментов и памяти → переплачиваешь токенами на служебный ReAct-промпт, получаешь то же, что дал бы Basic LLM Chain. Без tools — Chain.
  • Взял нативную ноду OpenAI ради «структурированного JSON» → парсера у нативной ноды нет, ответ парсишь сам в следующей Code-ноде. Если нужен валидированный JSON по схеме — Basic LLM Chain с Output Parser sub-нодой.
  • Подключил Chat Memory к Basic LLM Chain и ждёшь, что бот «запомнит» предыдущее сообщение → Basic LLM Chain не ведёт диалог, он делает один запрос за вызов. Для памяти диалога нужен AI Agent.
  • Сменил вендора в нативной ноде → надо переписывать всю ноду заново (поля разные у OpenAI и Anthropic). В Basic LLM Chain / AI Agent — меняется только sub-нода Chat Model, остальное остаётся.
3.1
Добавь ноду Basic LLM Chain

На canvas нажми + справа от RSS Feed Trigger. В поиске нод начни вводить basic llm → выбери Basic LLM Chain. Нода появится на canvas и автоматически подключится к триггеру.

3.2
Переключи Source for Prompt на Define below

Открой ноду двойным кликом. Первый параметр — Source for Prompt (User Message) — по умолчанию стоит на Connected Chat Trigger Node.

Это значит что нода ждёт текст из Chat Trigger. У нас триггер не чат, а RSS — поэтому открой выпадающий список и выбери Define below.

После этого появится поле Prompt (User Message) — туда мы сами впишем инструкцию для модели и подставим текст статьи из RSS.

📖Source for Prompt в Basic LLM Chain — два режимастатья · ~2 мин

Source for Prompt — откуда Basic LLM Chain берёт текст для модели

У ноды Basic LLM Chain есть параметр Source for Prompt (User Message). Он управляет тем, откуда нода берёт пользовательский текст для передачи в языковую модель. Такой же параметр с теми же двумя режимами есть у AI Agent.

Connected Chat Trigger Node (дефолт) — нода ожидает что в воркфлоу есть Chat Trigger. Текст сообщения из чата автоматически передаётся в модель как prompt пользователя.

Точнее, в этом режиме нода берёт текст из поля chatInput входящего элемента. Пока между Chat Trigger и нодой ничего не стоит, поле на месте. Если перед нодой стоит нода, которая заменяет элемент и выбрасывает chatInput, — например Guardrails, — запуск падает с ошибкой No prompt specified, хотя Chat Trigger в воркфлоу есть.

Define below — нода не ждёт Chat Trigger. Ты сам формируешь prompt в поле Prompt (User Message): пишешь статичный текст инструкции и/или вставляешь данные из предыдущих нод через drag-and-drop.

Когда использовать Define below:

  • Триггер — не чат (RSS, Schedule, Webhook, Form)
  • Нужно добавить в prompt данные из других нод (текст статьи, содержимое формы, результат HTTP-запроса)
  • Между чатом и нодой стоит нода, которая убирает поле chatInput: после Guardrails текст берут из её поля guardrailsInput — {{ $json.guardrailsInput }}

Типичный вид поля Prompt (User Message) в режиме Define below:

Сделай краткое саммари этой статьи в 3 предложениях: {{ $json.contentSnippet }}

Здесь первая часть — статичная инструкция, вторая — выражение с данными из RSS Feed Trigger.

3.3
Впиши в поле Prompt статичную инструкцию

В поле Prompt (User Message) напиши инструкцию для модели: Сделай краткое саммари этой статьи в 3 предложениях: (с пробелом в конце — следом сюда подставим текст статьи).

Это статичная часть prompt'а: одна и та же на каждом запуске. Дальше дополним её текстом конкретной статьи из RSS.

3.4
Перетащи contentSnippet в поле Prompt

В панели Input слева раскрой RSS Feed Trigger → перетащи поле contentSnippet в поле Prompt сразу после двоеточия (после пробела).

В поле появится выражение {{ $json.contentSnippet }} — итоговый Prompt будет выглядеть так: Сделай краткое саммари этой статьи в 3 предложениях: {{ $json.contentSnippet }}.

Поле contentSnippet берём намеренно — это короткий фрагмент статьи. Если взять content, в нём окажется весь HTML-текст статьи на десятки тысяч символов и модель упадёт с ошибкой context length exceeded. contentSnippet всегда укладывается в лимит модели.

📖Что такое expression в n8n и как она читает значения из других нодстатья · ~2 мин

Что такое expression

В n8n expression — это маленький кусочек кода в фигурных скобках, который динамически подставляет значение в поле ноды. Записывается так:

{{ <выражение> }}

В поле интерфейса = перед выражением писать не нужно: поле в режиме Expression уже трактует содержимое как выражение, а знак = n8n сам добавляет в файле воркфлоу (JSON) как маркер. Если напечатать = самому, он попадёт в результат текстом (например, сообщение начнётся с «=🚨»). Если поле осталось в режиме Fixed, {{ ... }} запишется как обычный текст.

Внутри {{ }} пишется JavaScript-выражение. Самое частое — чтение значения из другой ноды.

Зачем нужны expressions

Каждое поле в параметрах ноды может быть либо фиксированным значением (например, URL https://api.example.com), либо expression'ом — формулой, которая считается на лету в момент исполнения ноды. Expressions нужны, когда значение зависит от данных, пришедших из предыдущей ноды.

К примеру
Где это встречается

К примеру, ты сделал ноду «прочитать строку из таблицы конфига», а следующая нода — HTTP Request к внешнему API. В URL этой HTTP-ноды можно подставить значение из конфига: {{ $('Get Config').item.json.api_url }} — n8n при каждом исполнении возьмёт актуальный URL из таблицы, а не зашитый в ноду.

Как читать значения из других нод

Базовая формула: {{ $('<имя_ноды>').item.json.<поле> }}

Разбор по частям:

  • $('<имя_ноды>') — обращение к ноде по имени (то, что написано на холсте под нодой). Имя — в одинарных кавычках, точно как на холсте.
  • .item — текущий элемент, который обрабатывается. У большинства нод элементов несколько (массив), item берёт тот, что соответствует текущей итерации.
  • .json — содержимое поля json элемента (там лежат все данные, которые нода вернула).
  • .<поле> — конкретное поле внутри json. Если поле вложенное — пишется через точку: .config.embedding_model.

Пошагово — как вставить expression в поле

  1. Наведи курсор на поле и переключи Fixed → Expression в правом верхнем углу поля (или просто начни вводить {{ — поле само перейдёт в режим expression).
  2. В появившемся окне (expression builder) — слева список нод воркфлоу, можно кликать по полям и они вставятся в формулу.
  3. Справа — preview: видно, какое значение получится прямо сейчас. Если красным — формула или путь к полю некорректные.
  4. Закрой окно, поле остаётся в режиме expression (синий фон + иконка fx).
Типичная ошибка
Поле в режиме `Fixed` вместо `Expression`

Если вставил {{ ... }} в поле, которое осталось в режиме Fixed, n8n запишет текст {{ ... }} как есть, и нода уйдёт делать HTTP-запрос на URL вроде {{ $('...').item.json.api_url }} буквально. Симптом — ошибка Invalid URL или 404 на странную строку. Лечение: переключи поле в Expression. И наоборот, = в начале вручную не печатай — он попадёт в результат.

Типичные ошибки

  • Имя ноды не совпадает. В формуле $('Get Config') имя должно точно совпадать с подписью ноды на холсте. Если переименовал ноду — старые expressions, ссылающиеся на неё, сломаются.
  • Путь к полю не существует. .item.json.embedding_dimensions упадёт с undefined, если у элемента такого поля нет. Проверка — посмотри preview в expression builder, он сразу показывает значение или ошибку.
  • Поле осталось в режиме Fixed. Самая частая ошибка — описана в callout выше.
  • Кавычки внутри {{ }}. Внутри expression строки оборачиваются одинарными кавычками: {{ 'Hello ' + $json.name }}; двойные тоже работают. Поля с кириллицей и пробелами читаются как $json["Имя"].

Когда expression не нужен

Иногда поле должно быть фиксированным. Например, метод HTTP-запроса (GET / POST) или имя коллекции, которое одинаково для всего воркфлоу — нет смысла читать его динамически. Простое правило: если значение меняется от итерации к итерации или зависит от пришедших данных — нужен expression; если значение постоянное — оставляй фиксированным.

⚡Как передать данные из одной ноды в другую через drag-and-dropстатья · ~2 мин

Перетаскивание полей из Input panel

Когда нужно подставить значение из предыдущей ноды в параметр текущей, не пиши выражение вручную. Открой ноду двойным кликом. Слева откроется Input panel с деревом полей предыдущей ноды. Справа — node parameters.

Раскрой нужное поле в Input panel и перетащи его мышкой в parameter's field. n8n сам сформирует выражение и переключит поле из режима Fixed в Expression.

Как это работает

Input panel показывает данные из OUTPUT предыдущей ноды. Данные приходят в виде дерева: каждое поле можно раскрыть до примитива.

После drop в parameter's field появляется выражение в двойных фигурных скобках. n8n поддерживает два формата:

  • $json.<field> — когда данные идут напрямую из предыдущей ноды по главной ветке;
  • $('<NodeName>').item.json.<field> — когда нужно явно указать имя ноды-источника.

n8n сам определяет нужный item через item linking. Ручной поиск соответствия не требуется.

Поле автоматически окрашивается и переключается в режим Expression. Альтернатива — открыть expressions editor и написать то же выражение вручную. Результат идентичен.

Вложенные поля раскрываются через точку: $json.body.city.

Правило одной строкой
Перетаскивай только до примитива

Если перетащить объект-обёртку, в поле попадёт [object Object]. Всегда раскрывай дерево до конечного значения.

Типичные ошибки

  • Перетащил объект-обёртку вместо примитива → в поле уходит [object Object] → раскрой дерево до листа.
  • Дропнул в соседнее поле параметра (Text вместо Chat ID) → нода работает не на тех данных → визуально проверь куда легло выражение.
  • Переименовал ноду уже после drag-and-drop → expression $('старое имя') сломался → верни старое имя или перепиши выражение вручную.
  • Впечатал статичное значение через drag вместо обычного текста → лишнее выражение там где значение не меняется → для констант просто впечатывай текст.
  • Тащишь из ноды через ветку которая не выполнялась → expression вернёт undefined → проверь что нужная ветка реально дошла до текущей ноды.
3.5
Проверь параметры Basic LLM Chain
Параметры Basic LLM Chain
ПараметрЗначение
Source for Prompt (User Message)Define below
Prompt (User Message)Сделай краткое саммари этой статьи в 3 предложениях: {{ $json.contentSnippet }}
Require Specific Output Formatoff
3.6
Добавь sub-ноду OpenAI Chat Model

Закрой ноду. Под Basic LLM Chain ты увидишь хвост с подписью Model*.

Кликни на него → в окне выбора ноды начни вводить openai chat → выбери OpenAI Chat Model.

Sub-нода появится снизу и автоматически подключится к Basic LLM Chain через коннектор Model.

🔀Что такое sub-нода в n8n и как её заменитьстатья · ~2 мин

Что такое sub-нода

В n8n AI-ноды устроены как «родитель + дети». Родитель — основная нода (AI Agent, Qdrant Insert, Qdrant Vector Store…). Дети — sub-ноды, которые подключаются к специальным кружкам на нижней стороне родителя. Каждая sub-нода — это «поставщик ресурса» для родителя.

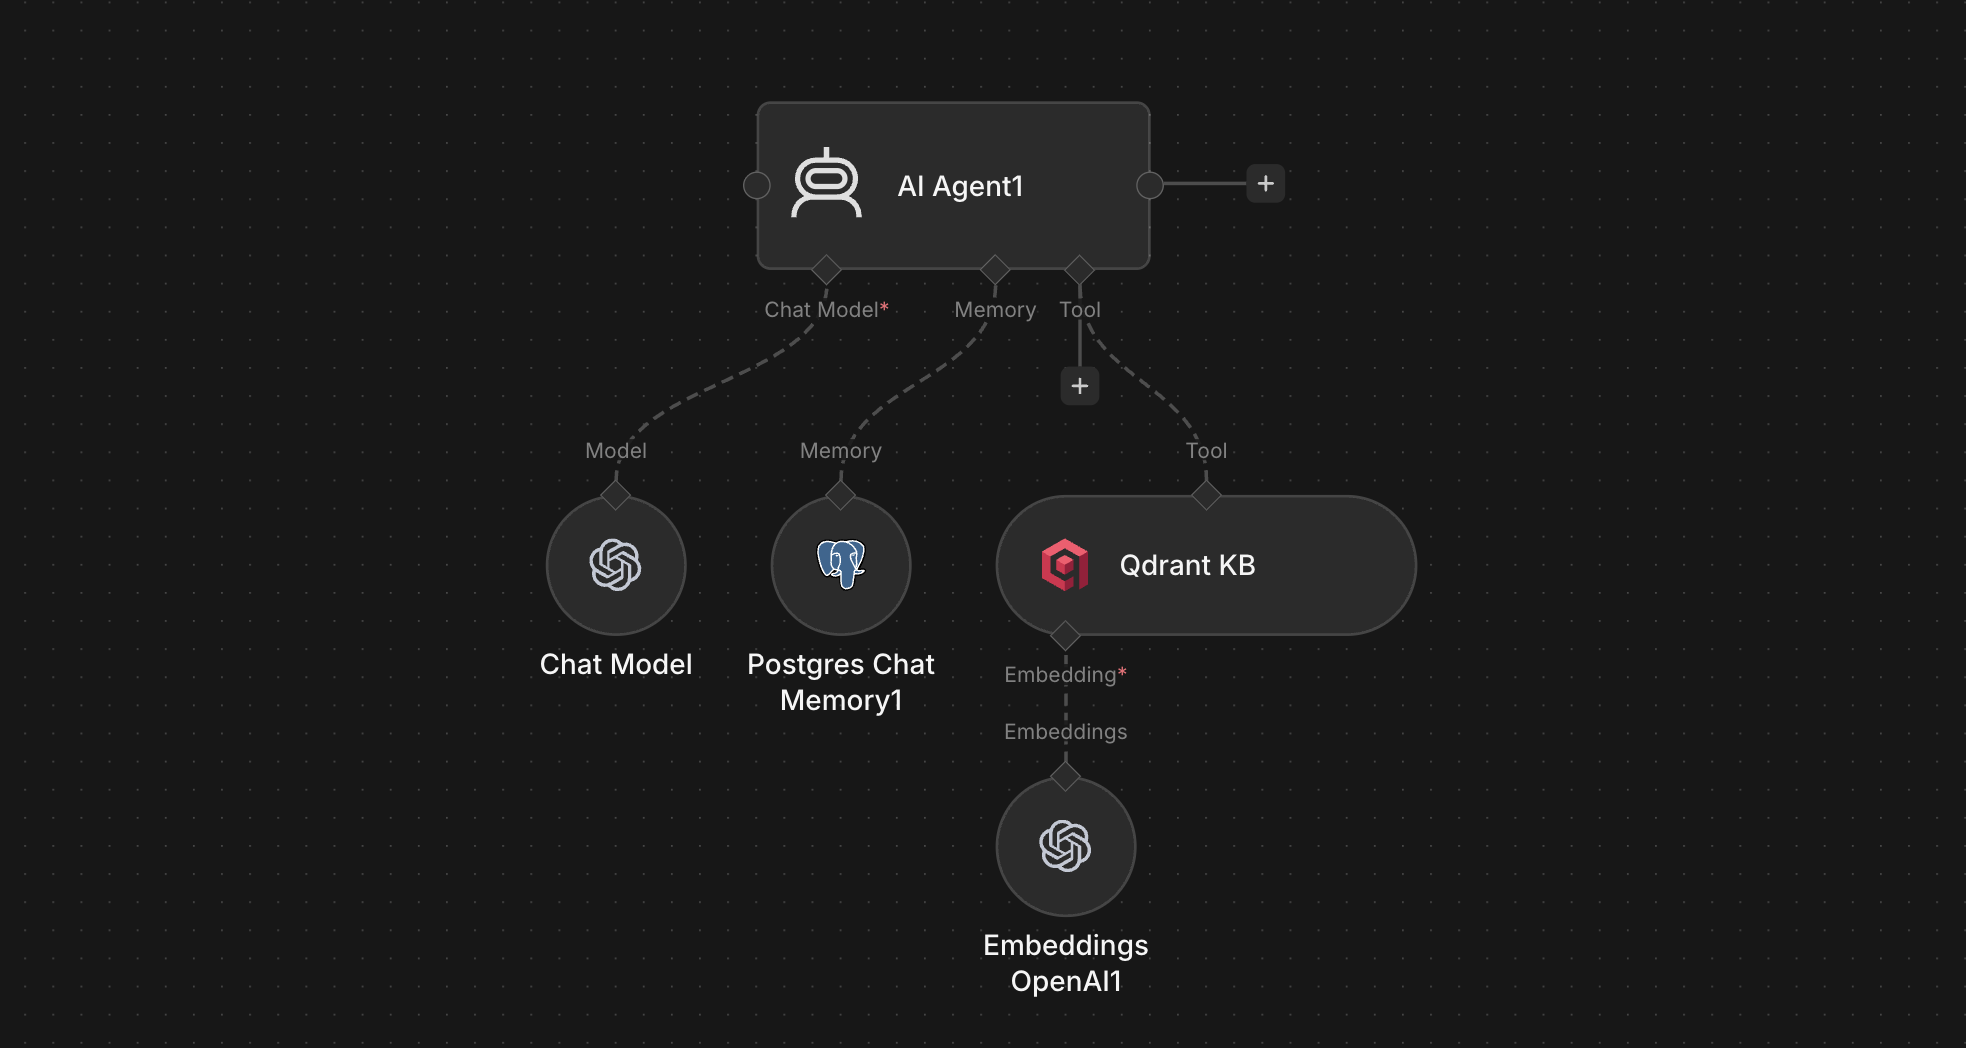
AI Agent (родитель) с подключёнными sub-нодами Chat Model и Tool, и пустым слотом Memory

Какие бывают sub-ноды

  • Embeddings — поставляет векторы (OpenAI / Cohere / Voyage / Google Gemini / bge / …).
  • Chat Model — поставляет LLM для AI Agent, Basic LLM Chain и других AI-нод, например Guardrails.
  • Document Loader — поставляет «нарезанные» куски документа.
  • Text Splitter — внутри Document Loader, разбивает на чанки.
  • Memory — поставляет историю диалога для AI Agent.
  • Tool — поставляет инструменты, которые AI Agent может вызвать.

Когда родитель запускается (например, Qdrant Insert получил файл и собирается записать его в БД), он по очереди обращается к sub-нодам: «дай мне чанки», «переведи каждый чанк в вектор». Sub-ноды отвечают, родитель собирает результат.

Как выглядит sub-нода в параметрах родителя

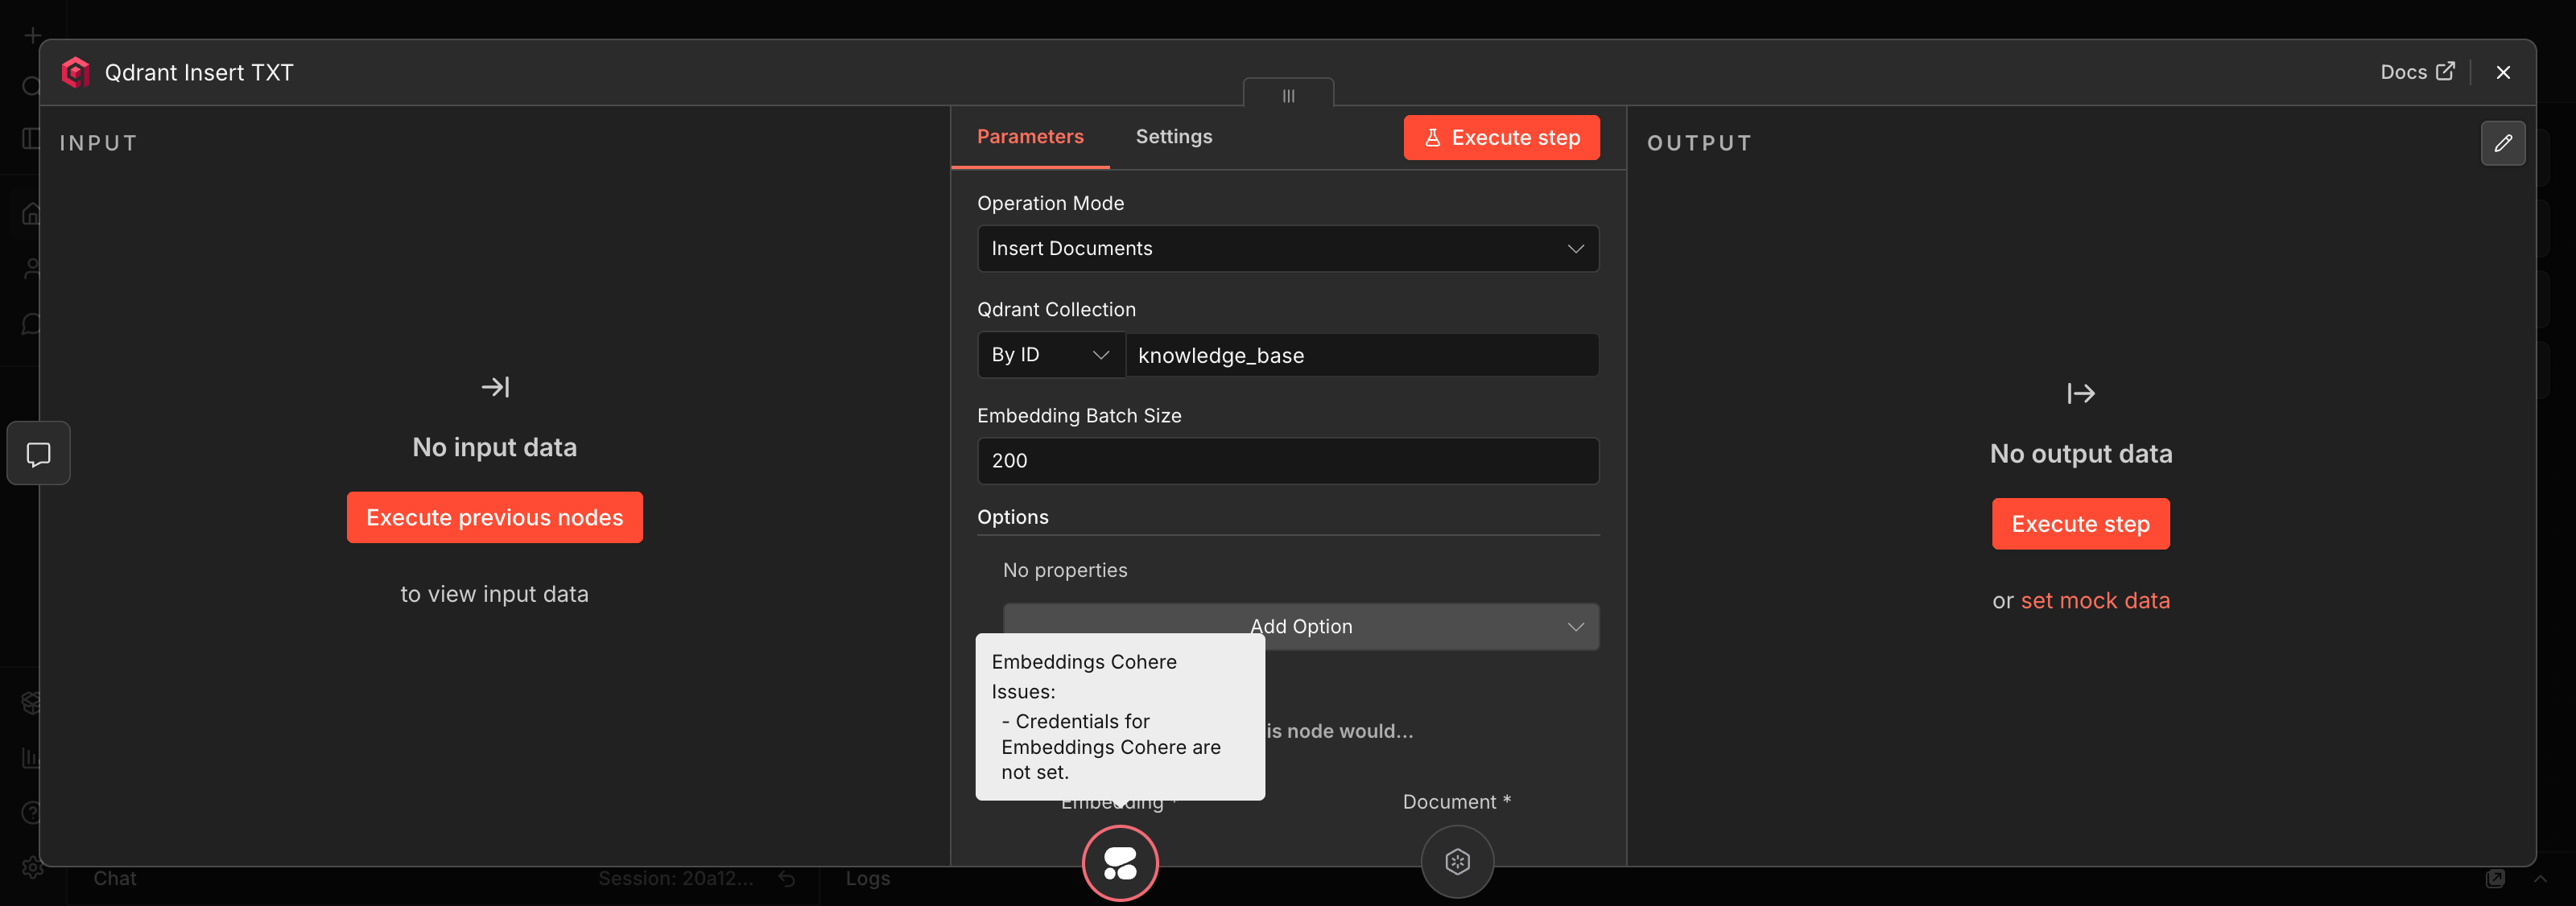
Если открыть параметры родителя двойным кликом — справа выезжает панель параметров, а на нижней границе панели видны кружки sub-нод. Подключённая sub-нода показана как круглый цветной индикатор с иконкой провайдера. При наведении — всплывающая подсказка с именем и статусом.

Панель параметров ноды Qdrant Insert TXT — на нижней границе видны слоты Embedding и Document, к Embedding подключена sub-нода Embeddings (видна всплывающая подсказка)

Как заменить sub-ноду

  1. Закрой панель параметров родителя (Esc).
  2. На canvas найди подключённую sub-ноду — она расположена под родителем. Кликни на ней, нажми Delete (или правый клик → Delete). Sub-нода удалится, у родителя освободится слот.
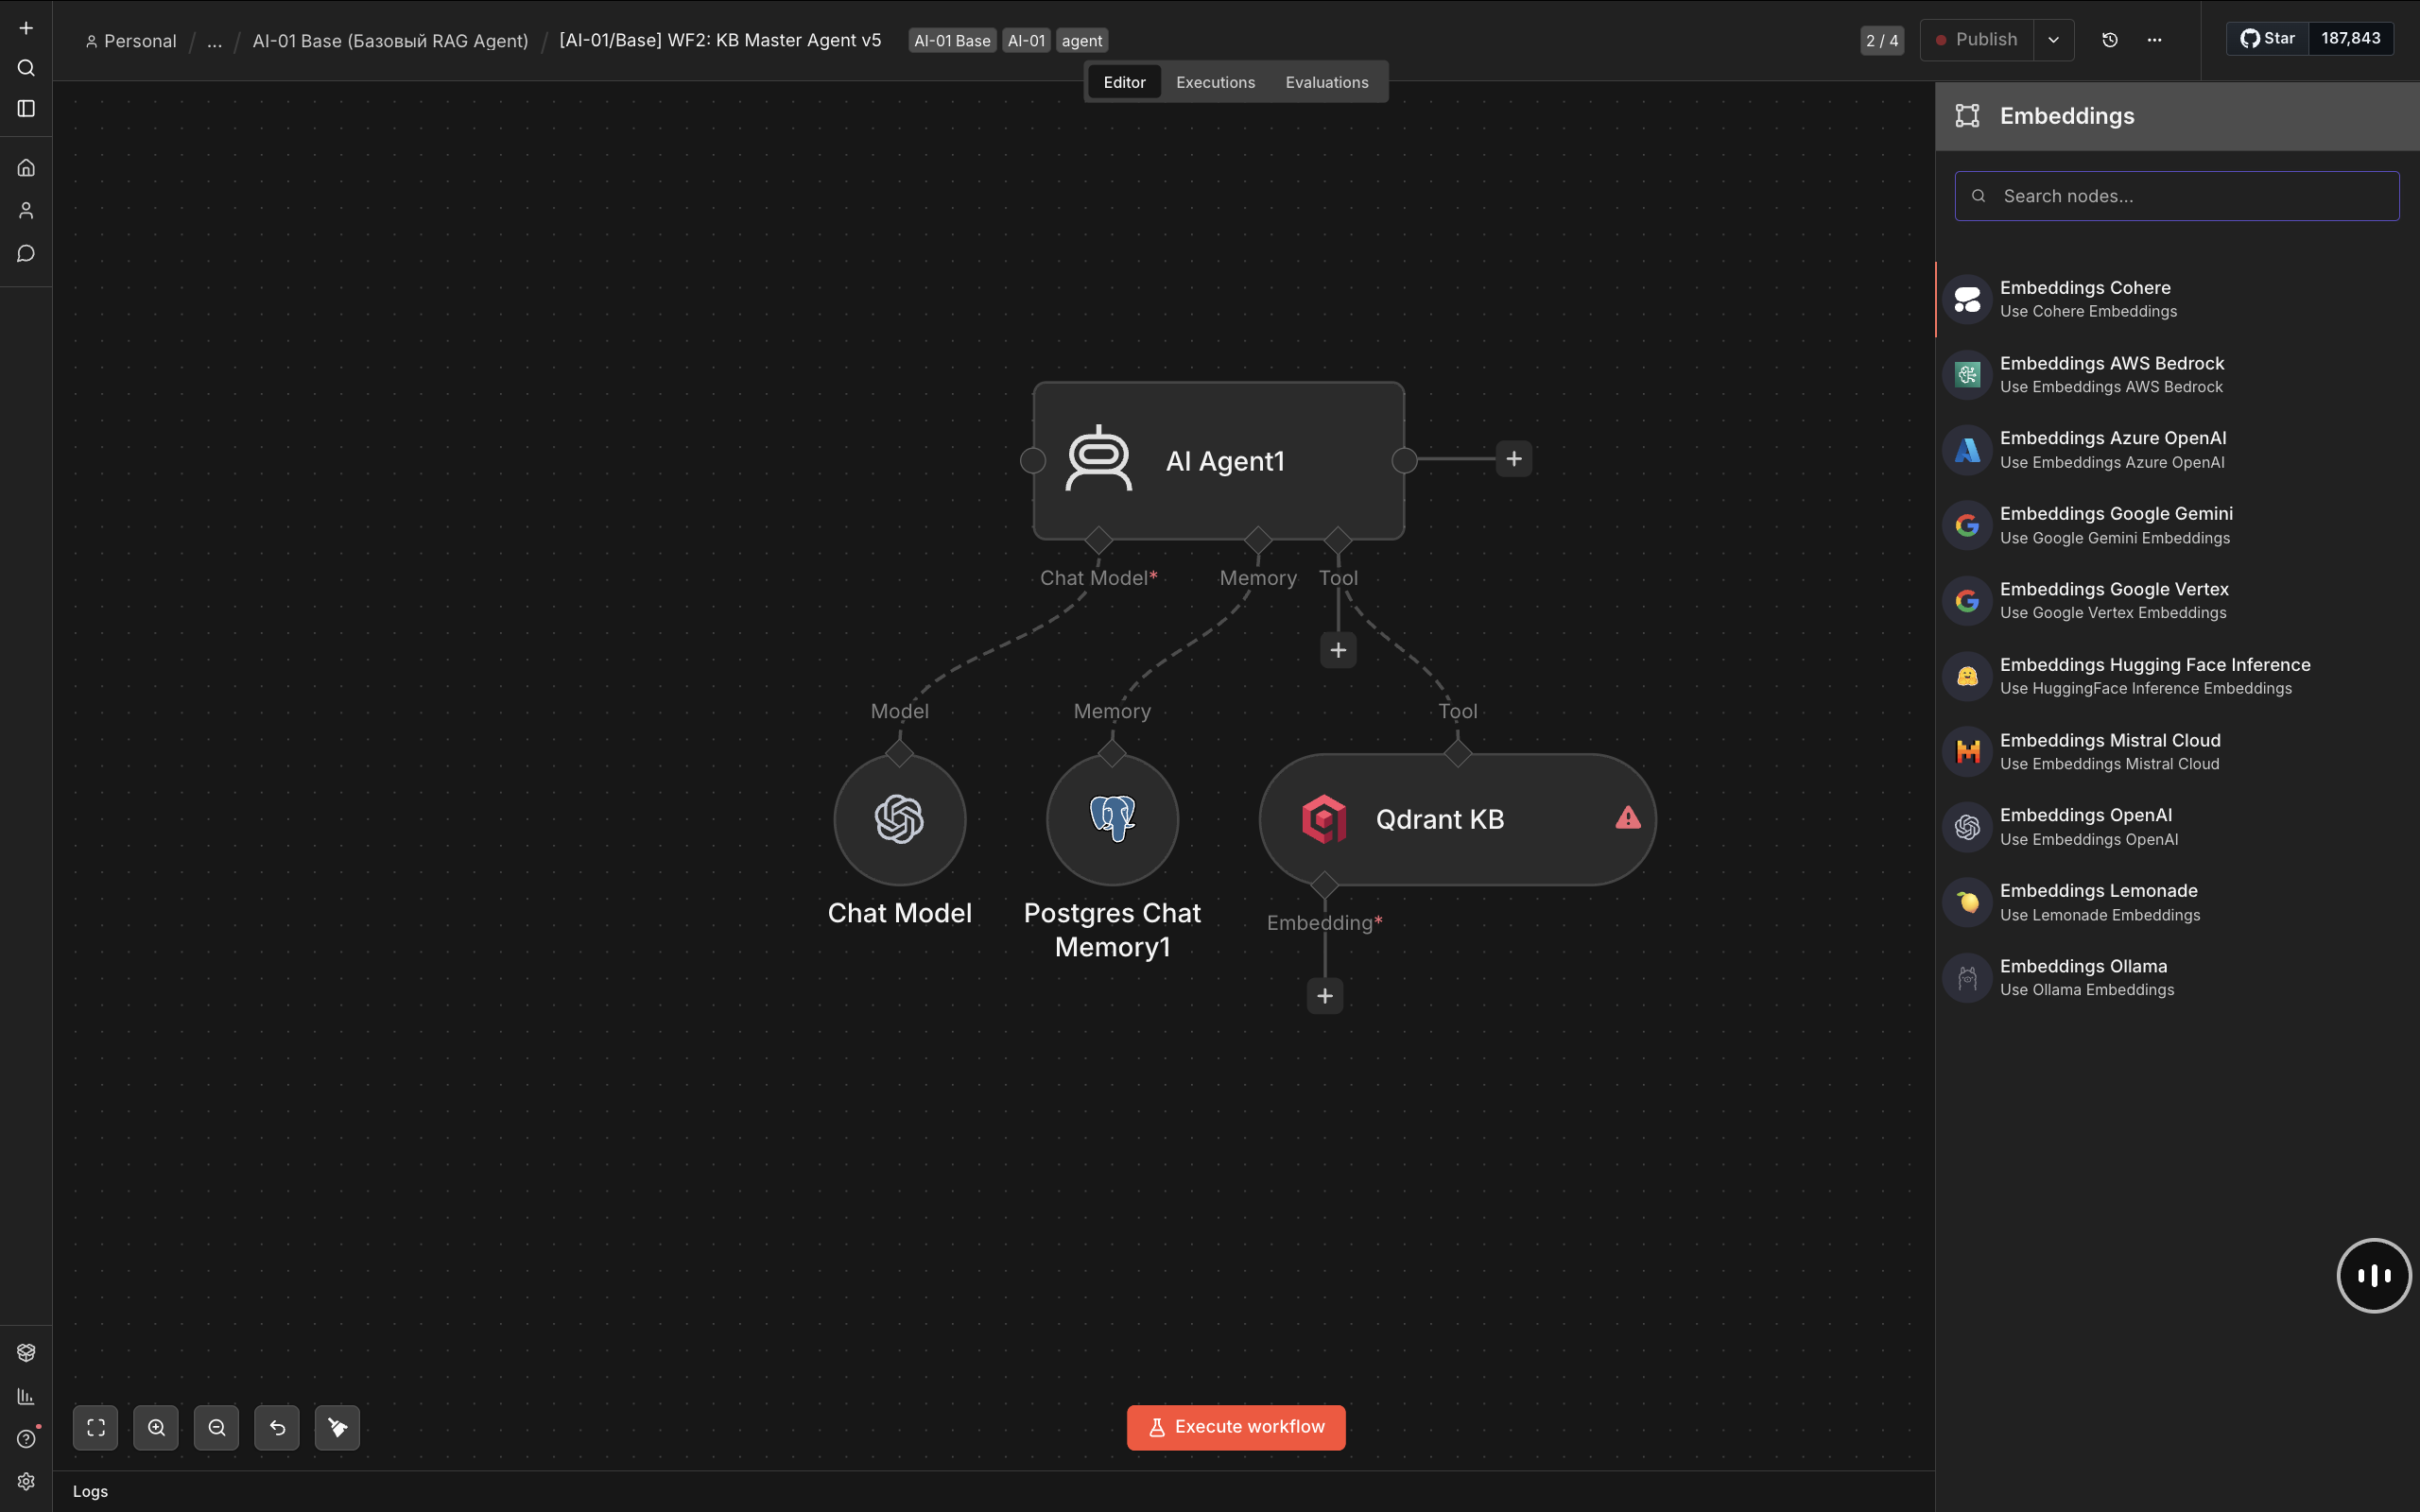
  3. На родителе освободившийся слот покажет «+» (например, Add document embedding). Нажми — справа откроется список доступных sub-нод нужного типа.
Список доступных Embedding sub-нод: Cohere, AWS Bedrock, Azure OpenAI, Google Gemini, Google Vertex, Hugging Face и др.
  1. Выбери нужную sub-ноду — она автоматически подключится к родителю на освободившемся слоте.
  2. Заполни параметры новой sub-ноды (credential, модель, режим).
Важно
Заменяешь sub-ноду — проверь всех её родителей

Одну sub-ноду можно подключить к нескольким родителям: например, одну модель — к агенту и к цепочке Basic LLM Chain, одну ноду памяти — к агенту и к Chat Memory Manager (n8n 2.20.7). Тогда замена этой sub-ноды меняет поведение всех родителей сразу. А если у каждого родителя своя sub-нода (например, две ноды Qdrant Insert — для txt и для pdf — и у каждой своя Embeddings), заменить нужно в каждом родителе отдельно.

3.7
Проверь credential OpenAI

Открой sub-ноду OpenAI Chat Model. В поле Credential должен быть выбран credential OpenAi account (он создан в твоём инстансе заранее школой).

Если credential не подставился автоматически — выбери его из выпадающего списка.

🔑Как добавить credential в n8nстатья · ~1 мин

Универсальный процесс добавления credential

Credential в n8n — это сохранённая «учётка» для подключения к сервису (API-ключ, OAuth-токен, логин/пароль и т.д.). Любая нода, которой нужна авторизация, выбирает credential из общего списка — поэтому добавлять его нужно один раз, а использовать можно из любого количества нод того же типа.

Пошагово

  1. В левом меню n8n открой раздел Credentials.
  1. Нажми кнопку Add credential (правый верхний угол).
  1. В поиске введи название нужного типа credential — например, OpenAI, Header Auth, Postgres, Google — и выбери его из списка.
  1. В шапке формы дай credential понятное имя — например, OpenAI школа или Postgres prod. По этому имени ты будешь выбирать его в нодах.
  1. Заполни поля формы. Какие именно — зависит от типа: для API-ключевых это обычно одно поле API Key, для Header Auth — Name и Value заголовка, для Postgres — host/port/database/user/password, для OAuth — запуск OAuth-flow по кнопке.
  1. Нажми Save. Готово — credential можно подключать к любой ноде, которая поддерживает этот тип.
Подсказка
Один credential — много нод

Один сохранённый credential можно использовать в неограниченном количестве нод одного типа. Если ключ протухнет — поменяй его в credential один раз, обновится во всех нодах сразу.

Кстати
Какие поля заполнять у конкретного типа

Этот гайд — про универсальный процесс. Какие поля и какие значения вводить у конкретного credential (OpenAI API, Header Auth, Postgres и т.д.) — смотри в inline-статье на этот тип, она будет рядом со ссылкой на текущую.

⚙LiteLLM-прокси школы — единый шлюз для платных моделейстатья · ~2 мин

Один URL вместо ключей всех провайдеров

LiteLLM-прокси — это единый шлюз, который принимает запросы в формате OpenAI и пересылает их к разным платным моделям: OpenAI, Anthropic, DeepSeek, Cohere и другим. Студент работает только с одним адресом и одним набором настроек.

Школа поднимает прокси, чтобы все студенты ходили через общий счёт. Школа платит провайдерам по одному договору и видит расход токенов каждого студента по отдельности. Студенту не нужно заводить личные billing-аккаунты и следить за лимитами.

OpenAI-совместимый интерфейс позволяет использовать прокси в n8n и SDK без изменений кода. Ноды и библиотеки отправляют запросы на школьный адрес, а не напрямую на api.openai.com.

Как это работает

В n8n credential OpenAi account указывает Base URL школьного прокси. Все запросы к моделям DeepSeek, Claude и остальным идут через этот credential. Модель указывается в параметре model как обычно.

Прокси не хранит модели у себя. Он только маршрутизирует запросы к внешним API и возвращает ответы. Поэтому он не заменяет self-hosted решения вроде Ollama.

Прямой ключ провайдера нужен только в двух случаях: когда требуется Assistants API или когда нужны параметры, которые прокси ещё не поддерживает. В остальных задачах весь трафик идёт через OpenAi account.

Правило одной строкой
Прокси — это маршрутизатор, а не модель

LiteLLM-прокси не запускает модели локально и не добавляет новых провайдеров. Он принимает OpenAI-формат и пересылает запросы дальше.

Типичные ошибки

  • Считаешь OpenAi account отдельной моделью → запрос уходит не туда → выбирай имя модели из списка, который даёт школа.
  • Меняешь значение model на имя из документации провайдера → модель не находится → уточняй у школы, какое имя доступно через прокси.
  • Пытаешься вызвать Assistants API через прокси → запрос падает → используй прямой ключ OpenAI.
  • Думаешь, что личный ключ запрещён → можно использовать, но по умолчанию весь учебный трафик должен идти через OpenAi account.
  • Путаешь прокси с self-hosted моделью → ждёшь, что модели работают без интернета → LiteLLM только пересылает запросы к платным API.
3.8
Выбери модель deepseek-chat

В поле Model оставь режим From list и выбери из выпадающего списка значение deepseek-chat.

3.9
Выключи переключатель Use Responses API

Прямо в параметрах ноды найди переключатель Use Responses API и убедись что он выключен (off).

Это особенность школьного LiteLLM-прокси. При включённом тоггле нода обращается к эндпоинту /v1/responses, который прокси не поддерживает, и нода падает с ошибкой. С выключенным тоггл нода идёт на /v1/chat/completions — это стабильный путь.

📖Responses API vs Chat Completions: два разных эндпоинта OpenAIстатья · ~3 мин

Два эндпоинта к одним моделям

У OpenAI два разных эндпоинта для одних и тех же моделей: /v1/chat/completions и /v1/responses. Оба принимают запросы к gpt-4o и другим моделям, но формат запроса и ответа у них несовместим.

Chat Completions — старый и до сих пор поддерживаемый путь. Responses API — новый интерфейс, который OpenAI рекомендует для агентских сценариев.

Ключевое отличие не в модели, а в том, как ты передаёшь данные и хранишь контекст.

Как это работает

Chat Completions принимает массив messages. В ответе модель возвращает одно сообщение в choices[0].message. Всю историю разговора клиент должен хранить и отправлять заново при каждом запросе.

Responses API использует параметр input — это может быть строка или массив typed items. Поле instructions вынесено отдельно от сообщений. В ответе приходит массив typed output items (message, reasoning, function_call и другие).

Responses поддерживает stateful-цепочки через previous_response_id: OpenAI хранит предыдущие сообщения на своей стороне. Токены предыдущих запросов при этом всё равно учитываются при биллинге.

В Responses встроены инструменты Web Search, File Search и Code Interpreter — их можно включить без написания собственных функций.

В n8n-ноде OpenAI Chat Model есть переключатель Use Responses API, который меняет эндпоинт запроса. Через школьный прокси LiteLLM результат зависит от ноды, к которой подключена модель: AI Agent отвечает в обоих положениях, но с включённым переключателем n8n записывает в выполнение только оценку расхода — tokenUsageEstimate, где токены ответа модели всегда 0; Text Classifier с включённым переключателем падает на каждом элементе. С выключенным переключателем запрос идёт на /v1/chat/completions, и в выполнении виден настоящий расход — блок tokenUsage. Поэтому в задачах школы переключатель выключают всегда.

Это именно разные эндпоинты: формат Chat Completions, отправленный на /v1/responses, не сработает, и наоборот.

Правило одной строкой
Разные форматы — разные эндпоинты

Выбор эндпоинта определяет структуру запроса и ответа. Модель при этом остаётся той же. Передача полей input, instructions или previous_response_id на /v1/chat/completions приводит к ошибке валидации.

Типичные ошибки

  • Оставили Use Responses API включённым при работе через школьный LiteLLM-прокси → у AI Agent в выполнении нет настоящего расхода токенов, только оценка с нулём на ответе, а Text Classifier падает на каждом элементе → выключи переключатель.
  • Перенесли готовый воркфлоу с прямого OpenAI на прокси и не тронули тоггл → часть нод падает, у остальных пропадает настоящий расход токенов → проверь состояние переключателя в каждой OpenAI-ноде.
  • Передали в запрос к /v1/chat/completions поля input, instructions или previous_response_id → ошибка валидации или поля просто игнорируются → используй только массив messages и храни историю на стороне клиента.
  • Решили, что Responses API нужен только для новых моделей → gpt-4o доступен по обоим эндпоинтам, разница только в формате → не путай выбор эндпоинта с выбором модели.
3.10
Проверь параметры OpenAI Chat Model
Параметры OpenAI Chat Model
ПараметрЗначение
CredentialOpenAi account
Model (режим)From list
Model (значение)deepseek-chat
Use Responses APIoff (выключено)

Связка настроена. Теперь её нужно протестировать.

3.11
Запусти Execute step на Basic LLM Chain

Открой ноду Basic LLM Chain и нажми кнопку Execute step в правом верхнем углу.

Нода выполнится на запиненных данных RSS:

возьмёт contentSnippet из output RSS Feed Trigger → подставит его в поле Prompt вместо выражения → отправит итоговый текст в sub-ноду OpenAI Chat Model → получит ответ модели → положит ответ в Output ноды в поле text.

Воркфлоу после шага 3: RSS Feed Trigger → Basic LLM Chain, снизу sub-нода OpenAI Chat Model
Воркфлоу после шага 3 — Basic LLM Chain и OpenAI Chat Model настроены
4Настрой ноду Telegram Send Message

Последняя нода — Telegram Send Message. Она отправит саммари из Basic LLM Chain в твой Telegram.

В поле Text мы передадим поле text из output Basic LLM Chain через drag-and-drop — точно так же, как только что протаскивали contentSnippet из RSS в Prompt.

4.1
Добавь ноду Telegram

Нажми на canvas + справа от Basic LLM Chain. В правой панели поиска нод введи telegram → выбери action-ноду Telegram → в открывшемся подменю в разделе Actions выбери Send a text message. Нода автоматически подключится к Basic LLM Chain.

4.2
Подключи credential Telegram

Открой ноду двойным кликом. В поле Credential выбери существующий Telegram Bot credential, если он уже был создан раньше.

Если списка пуст — нажми Create New Credential и вставь токен, который получил у @BotFather в шаге 1. Сохрани.

4.3
Найди свой Telegram ID

В поле Chat ID нужно указать числовой идентификатор чата — в данном случае твой личный Telegram ID.

📖Как узнать свой Telegram chat IDстатья · ~1 мин

Как узнать свой Telegram chat ID

chat_id — числовой идентификатор чата в Telegram. Bot API принимает его как целое число, потому что именно так хранится связь в базе Telegram и потому что username может измениться, а число — нет.

Для личных чатов твой chat_id совпадает с user_id и всегда положительный. Группы и каналы имеют отрицательный chat_id (для супергрупп начинается с -100).

Как это работает

API Telegram описывает chat_id как Integer. Значение может занимать больше 32 бит, поэтому для хранения в базе данных нужен 64-битный тип.

Получить свой chat_id можно двумя способами:

  • Отправь /start боту @userinfobot — в ответе придёт твой Id.
  • Открой Saved Messages в Telegram Web, в адресе после символа # будет число — это и есть chat_id.

В n8n это число вставляют в поле Chat ID ноды Telegram при отправке сообщения.

Числовой идентификатор надёжнее @username: API быстрее его обрабатывает и не зависит от смены имени пользователя. Для публичных чатов API ещё принимает строку с @username, но для личных контактов требуется именно число.

Важно
chat_id — это не username

API ждёт целое число. Если передать @username в поле, предназначенное для приватного чата, вернётся ошибка chat not found.

Типичные ошибки

  • Подставили @username вместо числа → Bot API вернёт Bad Request: chat not found → используй только полученное числовое значение.
  • Скопировали чужой пример с числовым ID → сообщения уйдут другому человеку → всегда получай chat_id одним из двух способов для своего аккаунта.
  • Перепутали личный chat_id и ID группы → ID группы отрицательный, личный — положительный → проверяй знак числа перед вставкой.
  • Сохранили chat_id в 32-битное поле базы данных → у части пользователей ID больше 2³¹ → используй 64-битный integer или double.
4.4
Нажми /start у своего бота в Telegram

Открой Telegram, найди своего бота (по username, который дал ему @BotFather в шаге 1) и нажми /start. Без этого бот не сможет написать тебе первым — Telegram блокирует исходящие сообщения от ботов в чаты, где пользователь сам не инициировал диалог.

4.5
Передай саммари в поле Text через drag-and-drop

В панели Input слева раскрой Basic LLM Chain → перетащи поле text в поле Text ноды Telegram.

В поле появится выражение {{ $json.text }}.

Это и есть саммари, которое Basic LLM Chain положил в свой output. $json — output предыдущей ноды (Basic LLM Chain), потому что Telegram подключён к ней напрямую. На каждом запуске воркфлоу здесь будет актуальное саммари свежей статьи.

4.6
Выключи Append n8n Attribution

Прокрути вниз до секции Additional Fields и раскрой её.

Найди параметр Append n8n Attribution и переключи его в положение off (должен стать серым).

Без этого в конец каждого сообщения будет дописываться This message was sent automatically with n8n — лишнее для саммари статьи.

⚙Append n8n Attribution: подпись в конце автоматических сообщенийстатья · ~2 мин

Append n8n Attribution: подпись в конце автоматических сообщений

Параметр Append n8n Attribution находится в ноде Telegram. По умолчанию он добавляет в конец каждого отправленного сообщения строку «This message was sent automatically with n8n».

Параметр спрятан: он появляется только после раскрытия Additional Fields. Значение по умолчанию — On, поэтому подпись появляется автоматически, если ничего не менять.

Зачем это нужно

Когда сообщение уходит реальному пользователю, упоминание n8n выглядит как реклама сервиса. Для тестовых и внутренних рассылок подпись иногда полезна — она сразу показывает источник. Для клиентских сообщений её отключают.

Как это работает

Параметр — простой переключатель внутри Additional Fields.

  • On (включён) — в конец текста дописывается фраза «This message was sent automatically with n8n».
  • Off (выключен, серый) — фраза не добавляется.

Чтобы добраться до переключателя, открой Parameters → Additional Fields → Add Field → выбери Append n8n Attribution.

Коротко
Когда выключать

Выключай для всех сообщений, которые получат живые люди вне команды. Оставляй включённым только в тестовых и внутренних сценариях.

Типичные ошибки

  • Параметр не виден на основном экране → ищут его в Parameters → нужно раскрыть Additional Fields через Add Field.
  • Оставили On для реальных пользователей → получатели видят упоминание n8n → переключи в Off, чтобы переключатель стал серым.
  • Перепутали с Parse Mode → правят соседний пункт → Parse Mode отвечает за форматирование, а Append n8n Attribution — только за подпись.
  • Выключили, но не проверили → подпись осталась → убедись, что переключатель серый.
4.7
Проверь параметры ноды
Параметры Telegram
ПараметрЗначение
CredentialTelegram Bot
ResourceMessage
OperationSend Message
Chat IDтвой числовой Telegram ID
Text{{ $json.text }}
Additional Fields → Append n8n Attributionoff
4.8
Запусти Execute step

Зайди в ноду и нажми Execute step в правом верхнем углу.

Если всё настроено верно, в твой Telegram придёт сообщение с саммари статьи. В панели Output ноды появится JSON-ответ Telegram API с ok: true и message_id.

Готовый воркфлоу: RSS Feed Trigger → Basic LLM Chain → Telegram, снизу sub-нода OpenAI Chat Model. Все ноды с галочками после Execute step
Готовый воркфлоу после шага 4 — все ноды настроены и протестированы

Все, воркфлоу собран. Можешь потестировать его, а потом выполнить Stretch (задачу со звездочкой)

🚀Stretch

Настрой своего бота, чтобы он отправлял интересные тебе новости. Поищи в интернете, есть ли у твоего любимого сайта RSS-лента.

Поработай над промптом модели, повыбирай разные модели.

Настрой сообщение от него так, чтобы его было приятно читать.

Тест-кейсы

ВходОжидаем
Обычная статья нормальной длины из RSS-лентыBasic LLM Chain возвращает в поле text краткое саммари из 3 предложений, Telegram доставляет его боту
Статья без полного поля content (только contentSnippet) в RSSВоркфлоу работает: prompt подставляет contentSnippet, модель делает саммари по короткому фрагменту
Поле Prompt оставлено в режиме Connected Chat Trigger Node (студент забыл переключить на Define below)Basic LLM Chain падает с ошибкой: ждёт Chat Trigger, которого в воркфлоу нет
Неверный URL в Feed URL — главная страница сайта без /rss/ или /feed/Fetch Test Event у RSS Feed Trigger возвращает ошибку парсинга XML, воркфлоу не идёт дальше
Воркфлоу опубликован (Publish), новых статей в источнике пока нетВоркфлоу проверяет RSS в фоне раз в минуту, сообщения в Telegram не приходят — это нормально
Помощь
Застрял где-то по ходу? Покажи в учебном чате скрин ноды и текст ошибки — разберёмся.
Написать в чат
Собрал воркфлоу? Сдай на ревью
Это демо — задачу можно прочитать целиком. Свой n8n, сдача на ревью и разбор открываются в аккаунте. Заведи аккаунт — модуль M0 бесплатно.

Можно аналитические cookie?

Аналитические cookie ставим только с твоего согласия: они помогают понять, что работает. Откажешься — аналитика обойдётся без них. Подробности — в политике обработки персональных данных.